[LSTM] LSTM의 동작 원리 3편: 자연어 처리(NLP)와 시계열 회귀
이번 건 1편, 2편과 같은 LSTM의 동작 원리는 아니고,
그냥 내가 궁금해서 LSTM을 사용한 자연어 처리(NLP)와 시계열 회귀를 비교해 봤다.
1편과 2편 링크는 여기
- LSTM의 동작 원리 1편
- LSTM의 동작 원리 2편
LSTM을 사용한 자연어 처리(NLP) vs. 시계열 회귀
LSTM의 내부 구조(메모리 셀, 게이트, etc.)는 어떤 데이터를 다루든 동일하다.
달라지는 것은 오직 마지막에 답을 내놓는 방식(Output Layer)와 채점 기준(Loss Function)이다.
| 구분 | 자연어 처리 (다음 단어 예측) | 일반 회귀 분석 (다음 숫자 예측) |
|---|---|---|
| 목표 | 다음에 올 단어(Class) 분류 | 다음에 올 숫자(Value) 예측 |
| 출력층 (Output) | Dense(단어장 크기, activation='softmax') |
Dense(1, activation='linear') |
| 손실함수 (Loss) | Categorical Crossentropy |
MSE (Mean Squared Error) |
실제 코드 예시: 시계열 주가 예측
1
2
3
4
5
6
7
8
9
10
11
12
  from tensorflow.keras.models import Sequential
  from tensorflow.keras.layers import LSTM, Dense

  model = Sequential()

  # 입력: (시간 단계 3일치, features 3개)
  # 예: 3일 동안의 [시가, 고가, 거래량] 데이터가 들어감
  # 50은 LSTM 층 내부의 노드 개수 (hidden units, 즉 모델이 추출할 추상적인 속성의 개수)model.add(LSTM(50, input_shape=(3, 3)))
  # 출력: 내일의 주가 (숫자 1개)
  # 활성화 함수는 보통 linear(기본값) 사용하여 숫자를 있는 그대로 출력함
  model.add(Dense(1))
  model.compile(optimizer='adam', loss='mse') # 오차는 MSE로 계산
시계열 회귀 모델에서 입력값($x_t$)의 의미: Feature Extraction
LSTM 블록 하나에 입력으로 들어가는 $x_t$는 우리가 가진 독립변수들의 값이다.
예를 들어 [시가, 고가, 거래량] 처럼 3개의 컬럼이 있다면, 길이 3짜리 벡터인 [1000, 1200, 50000]이 통째로 들어간다.
이 숫자들이 LSTM 내부로 들어가면 입력 벡터는 거대한 가중치 행렬($W$)과 곱해지면서 더 많은 개수의 추상적인 속성(Hidden Units)로 변환되며, 이를 Feature Extraction(특성 추출)이라고 한다.
- 입력 ($x_t$)
- 벡터:
[1000, 1200, 50000](길이: 3) - 우리가 눈으로 확인할 수 있는 물리적인 실제 값 (가격, 거래량, etc.)
- 벡터:
- 처리 (Matrix Multiplication)
- 길이 3짜리 벡터가 LSTM 내부의 가중치 행렬($W$)과 곱해진다.
입력(3) × 가중치(3×64) = 은닉상태(64)
- 결과 (Internal Attributes)
- 벡터:
[0.5, -0.9, 0.1, ..., 0.8](길이: 64) - 모델이 내부적으로 새롭게 만들어낸 64개의 추상적인 속성들
- 벡터:
이 값들은 단순한 랜덤 숫자가 아니라, 여러 독립변수가 섞여서 만들어진 의미있는 지표이다.
-
속성 1= (시가 × 0.8) + (거래량 × 0.2)-
속성 2= (고가 × -0.5) + (시가 × 0.5)- 이런 식으로 모델은 스스로 가중치 학습을 통해 데이터 안에서 예측에 필요한 새로운 패턴(속성)들을 알아내서 계산하고 만들어낸다.
[더 알아보기] LSTM의 출력 방식: Many-to-One vs. Many-to-Many
LSTM 모델을 설계할 때, 각 시점(Time Step)마다 나오는 단기 기억(Hidden State, h_t)을 어떻게 활용할 것인가에 따라 모델의 형태가 완전히 달라진다.
Keras 같은 프레임워크에서는 return_sequences라는 파라미터 하나로 이 두 가지 방식을 간단하게 조절할 수 있다!
아래 그림을 참고해서 설명하자면:
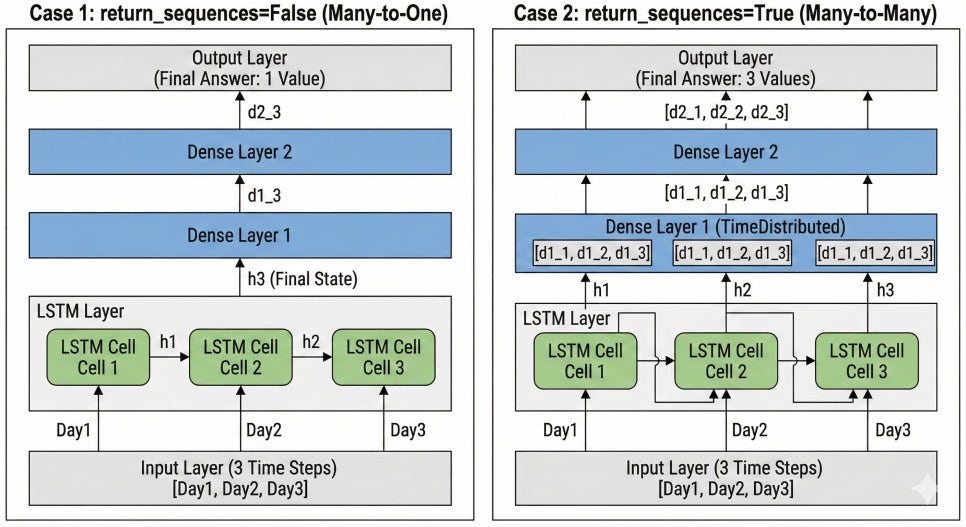 LSTM 출력 방식 비교 (Gemini 생성 이미지)
1 . Many-to-One (다대일)
-
가장 기본적이고 널리 쓰이는 방식
-
여러 개(Many)의 시간 단계 데이터를 입력받아 최종적으로 1개(One)의 결괏값만 내놓는다.
-
코드 설정:
return_sequence=False(default) - 작동 방식
-
Day1, Day2, Day3의 데이터가 순서대로 들어간다.
-
각 시점마다 단기기억($h_1$, $h_2$, $h_3$)이 내부적으로 만들어지지만, 중간 과정에서 나온 $h_1$, $h_2$는 다음 층(Dense Layer)으로 넘기지 않고 무시한다.
-
모든 시점의 처리가 끝난 후 나온 마지막 시점의 요약본($h_3$)만 Dense Layer로 전달하여 최종 결론 하나를 도출한다.
-
- 주로 쓰이는 곳
-
문장 감성 분류: ‘이 영화 정말 재미없고 지루해..’라는 여러 단어를 입력 → ‘부정적(0)’이라는 출력값 하나 생성
-
일반적인 시계열 예측: 과거 3일 치 주가 데이터 입력 → ‘내일의 주가’라는 출력값 하나 생성
-
2 . Many-to-Many (다대다)
-
여러 개(Many)의 시간 단계 데이터를 입력받아, 각 시점마다 결괏값을 하나씩, 총 여러 개(Many) 내놓는 방식
-
코드 설정:
return_sequences=True - 작동 방식
-
마지막 요약본만 넘기는 Many-to-One과 달리, 매 시점마다 생성되는 모든 단기 기억($h_1$, $h_2$, $h_3$)을 전부 다음 층(Dense Layer)로 올려보낸다.
-
결과적으로 3일 치 데이터를 넣으면, 각 날짜에 대응하는 3개의 최종 정답을 얻게 된다.
-
- 주로 쓰이는 곳
-
품사 태깅(POS Tagging): ‘나는(대명사) 밥을(명사) 먹는다(동사)’처럼 입력된 각 단어마다 품사를 판별해야 할 때
-
시계열 다중 예측: 입력된 각 시간 단계마다 다음 스템의 값을 예측해야 할 때
-
LSTM 층을 여러 개 쌓을 때(Stacked LSTM): 첫 번째 LSTM 층의 결과를 다음 LSTM 층이 온전히 다 받아야 하므로, 이때는 반드시
return_sequences=True로 설정해야 한다.
-