[LSTM] LSTM의 동작 원리 2편: Cell State와 세 개의 Gates
지난 게시물에서 LSTM 셀의 전체적인 큰 그림을 살펴봤었다.
LSTM은 기존 RNN의 단점이었던 장기 의존성(Long-Term Dependency) 문제를 해결하기 위해 장기 기억과 단기 기억을 분리해서 관리하는 구조를 가지고 있다고 했다.
이를 위해 셀 내부에는 정보의 흐름을 조절하는 3개의 게이트와 1개의 데이터 생성기가 있으며, 특히 핵심 정보를 끝까지 운반하는 Cell State(장기 기억)에 대해 알아봤다.
게이트를 하나씩 알아보기 전에 아주 쉬운 비유를 하자면:
기존 RNN
벼락치기를 해서 방금 본 마지막 페이지의 내용은 기억하지만, 책 앞부분 내용은 이미 다 까먹은 상태
LSTM
요약노트 (Cell State)를 가지고 있는 학생
1. 시험에 안 나올 것 같은 내용은 지우고(Forget Gate),
2. 새로 배운 중요한 내용은 추가로 적어두고(Input Gate),
3. 문제를 풀 때 노트를 참고해서 답을 적어냄(Output Gate)
LSTM의 컨베이어 벨트: Cell State
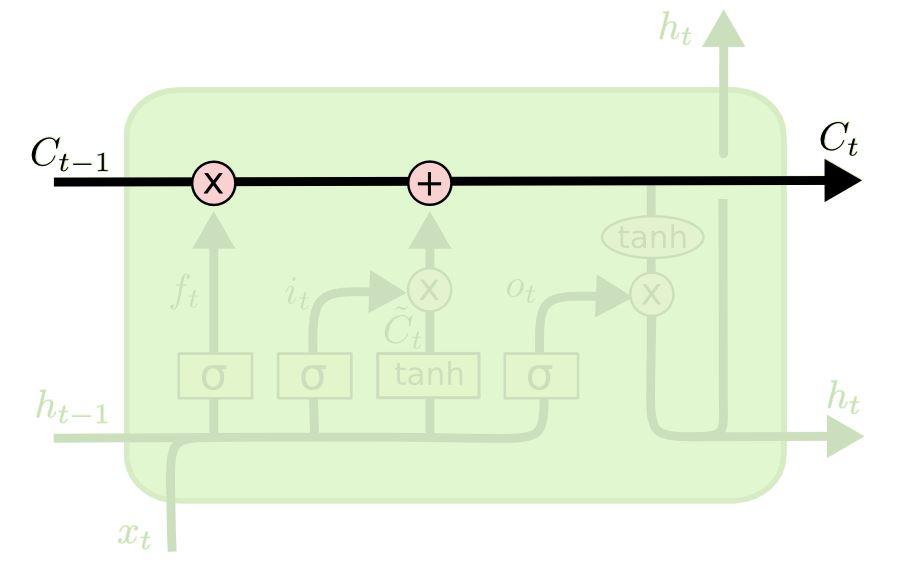 LSTM의 Cell State ($C_t$)
LSTM 블록의 제일 위쪽에 수평으로 이어진 선이 바로 Cell State($C_t$)다.
이 길을 통해 정보가 거의 변하지 않고 쭉 흘러갈 수 있어서, 아주 오래전의 정보도 끝까지 전달될 수 있다.
- 정보의 통과
-
이전 시점($C_{t-1}$)에서 넘어온 정보(기억)가 다음 시점으로 나갈 때까지 복잡한 변환 없이 직선으로 흐른다.
-
기존 RNN은 데이터를 계속 변형시켜서 (tanh와 같은 활성화 함수를 계속 거침) 나중에는 원래 형태를 알아보기 힘들지만, LSTM의 Cell State는 가벼운 선형 연산(덧셈, 곱셈)만 거치기 때문에 정보가 변질되지 않고 그대로 흘러갈 수 있다.
-
따라서 맨 처음에 들어왔던 중요한 정보가 먼 미래(끝부분)까지 살아남을 수 있게 된다.
⇒ 장기 의존성 문제 해결!
-
- 정보의 수정: 곱하기($\times$)와 더하기($+$)
-
그림의 위쪽 라인을 보면 두 가지 연산 장치가 달려있는 걸 확인할 수 있다.
- 곱하기(X): 정보를 얼마나 살릴지 죽일지 결정한다.
- 0을 곱하면 → 0이 되어 정보가 완벽하게 삭제된다. (forget)
- 1을 곱하면 → 원래 값이 그대로 유지된다. (keep)
- 더하기(+): 새로운 정보를 추가한다.
- 기존의 기억 흐름에, 이번 단계에서 중요하다고 판단된 새로운 기억을 얹어준다. (update)
💡 즉, LSTM의 Cell State는 이 컨베이어 벨트 위로 지나가는 정보(기억) 상자에, 중간중간 게이트(Gate)라는 작업자들이 붙어서, **'필요없는 건 빼고(X), 새로운 건 넣는(+)'** 작업을 수행하는 공장과 같다. -
그럼 여기서 생기는 질문: 중요한 정보와 필요 없는 정보를 구분하는 기준은 무엇일까?
이 판단을 위해 LSTM은 3개의 게이트(Gate) 를 사용하여 정보의 흐름을 조절한다.
3가지 게이트를 지나는 과정 (Forget Gate → Input Gate → Output Gate)
1 . 망각 게이트 (Forget Gate): 과거의 정보를 잊는 단계
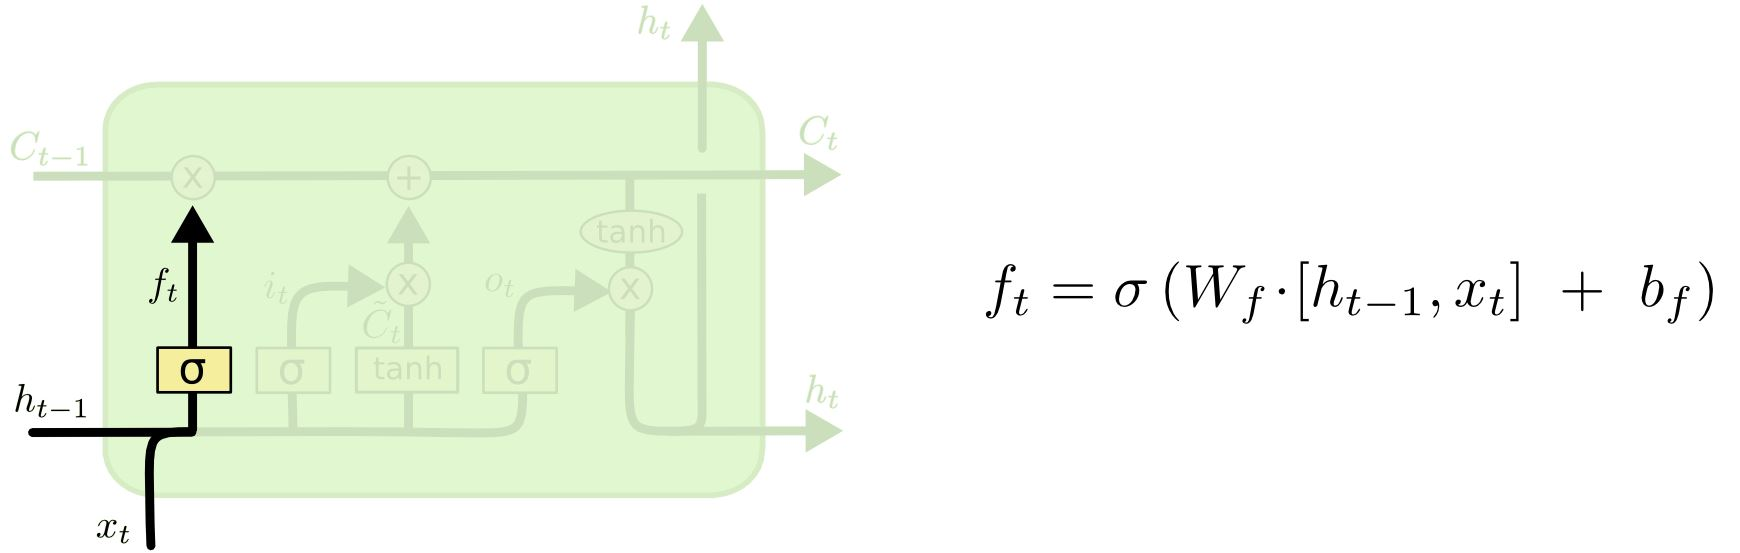 망각 게이트 단계
- 역할
- 과거의 정보($C_{t-1}$) 중 필요 없는 것을 버리고, 필요한 것만 남기는 단계
- 작동 원리
-
이전 시점의 은닉 상태($h_{t-1}$)와 현재 시점의 입력 데이터($x_t$)로 받아서 판단한다.
- 시그모이드($\sigma$) 함수를 통과시켜 0과 1 사이의 값을 내보낸다.
- 0에 가까우면 → 정보 삭제
- 1에 가까우면 → 정보 유지
- 이 값($f_t$)은 직전 셀 상태($C_{t-1}$)와 곱하기(X) 연산되어 실제 삭제가 이뤄진다.
-
- 예시 (Context Switching)
- “그는 밥을 먹었다”라는 문장이 끝나고 새로운 문장이 시작될 때, 이전 주어(‘그’)에 대한 설명 정보 등은 잊어도 된다. 이때 망각 게이트가 낮은 값(e.g. 0.1)을 출력하여 정보를 희미하게 만든다.
- $f_t$: 망각 게이트의 출력값 (0-1)
- $h_{t-1}$: 이전 시점의 은닉 상태 (단기 기억)
- $x_t$: 현재 시점의 입력 데이터
💡 왜 0/1 스위치(step function; 계단함수)가 아닐까??
⇒ 역전파(Backpropagation)를 통한 학습 때문
만약 0과 1만 있는 스위치(계단함수)라면?
- 그래프가 수직이거나 평평해서 미분값이 무한대이거나 0이 된다.
- 이렇게 되면 경사하강법을 적용할 수 없어, 모델이 '얼마나 잊어야 할지'를 학습할 수 없다.
0-1 사이의 연속적인 값(sigmoid; 시그모이드)이라면?
- 부드러운 곡선 형태로 미분(기울기 계산)이 가능하다.
- 따라서 모델이 조금씩 오차를 줄여가며 최적 의 망각 비율을 스스로 학습할 수 있다.
2 . 입력 게이트 (Input -Gate): 새로운 정보를 저장하는 단계
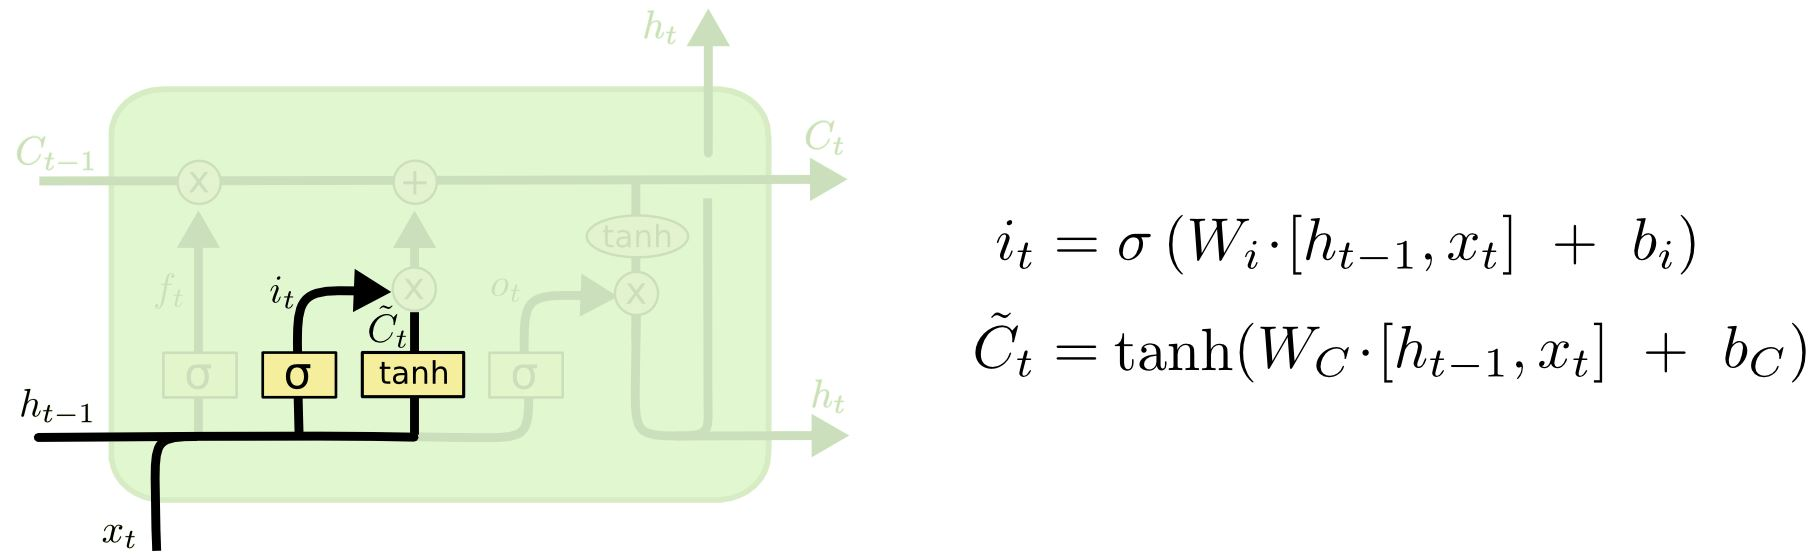 입력 게이트 단계
-
입력 게이트는 현재 들어온 정보 중 무엇을, 얼마나 Cell State(컨베이어 벨트)에 실을지를 결정하는 단계이다.
-
이 과정에서는 Sigmoid와 Tanh 이 두 가지 함수가 협력하여 수행한다.
a. 선별 담당(Sigmoid Layer): ‘얼마나 중요한 정보인가?’
- 작동 원리
- 현재 들어온 데이터($x_t$)와 이전 단기 기억($h_{t-1}$)을 보고, 각 정보의 중요도를 0-1 사이의 점수로 매긴다.
- 단어 전체가 아니라 ‘속성(차원)별’로 판단한다.
-
예를 들어, ‘그녀(She)‘라는 단어가 들어왔을 때, 이를
[0.9, 0.1, -0.5]같은 벡터로 인식한다. -
이때 입력 게이트는 문맥을 고려해 각 속성마다 다른 점수(가중치)를 매긴다.
-
e.g. 상황에 따른 중요도 판단
- 입력 단어: ‘그녀’ (
[성별정보, 존댓말여부, 감정상태]) - 현재 문맥: 주어를 기억해야 하는 상황
- Sigmoid(입력 게이트)의 판단 결과:
[0.99, 0.01, 0.01]- 첫 번째(
0.99): 성별 정보(여성)은 뒤에서 대명사(‘her’)를 맞추려면 중요하니까 확실하게 저장 (1에 가까운 값) - 두 번째(
0.01): 존댓말 정보는 지금 문맥에서 별로 중요하지 않으므로 무시 (0에 가까운 값) - 세 번째(
0.01): 감정 상태 또한 중요하지 않으므로 무시 (0에 가까운 값)
- 첫 번째(
- 입력 단어: ‘그녀’ (
-
단어 하나에 대한 점수를 매기는 것이 아닌, 단어를 표현하는 벡터의 각 속성(차원)마다 별도로 점수(0-1)를 매기는 것
b. 데이터 생성 담당 (Tanh Layer): ‘실제 저장할 내용은 무엇인가?’
-
선별 담당(Sigmoid)이 문을 열라고 신호를 보내도, 정작 들어올 데이터가 없다면 소용이 없다.
-
Tanh 층은 현재 데이터($x_t$)와 이전 기억($h_{t-1}$)을 바탕으로, Cell State에 더해질 새로운 후보값($\tilde{C_t}$)을 만들어낸다.
- 이 값은 -1 ~ 1 사이의 값을 가지며, 정보의 방향(긍정/부정, 증가/감소)을 나타낸다.
c. 최종 입력: $\sigma$와 $tanh$의 협력
- 두 함수의 계산이 끝났다면, 이제 두 값을 같은 위치끼리 곱한다 (중요도 X 실제 정보)
0.99(중요함) * 성별 정보= Cell State에 강하게 기록됨0.01(안중요) * 존댓말 정보= 0에 가까워져서 거의 기록되지 않음
-
이렇게 필터링을 거친 정보들을 Cell State(컨베이어 벨트)에 덮어씌워 장기 기억으로 만들어야 하는데,
이 과정에 대한 자세한 설명은 아래에서…~
💡 [여기까지 정리]
망각 게이트(Forget Gate)를 통해 '과거에서 버릴 것'을 정하고, 입력 게이트(Input Gate)를 통해 “현재에서 취할 것”을 결정했다!
이제 이 두 가지 정보를 가지고 실제 장기 기억 저장소(Cell State; 컨베이어 벨트)에 내용을 덮어씌워야 한다. - 작동 원리
+) 셀 상태 업데이트(Cell State Update) 단계: 기억 갱신
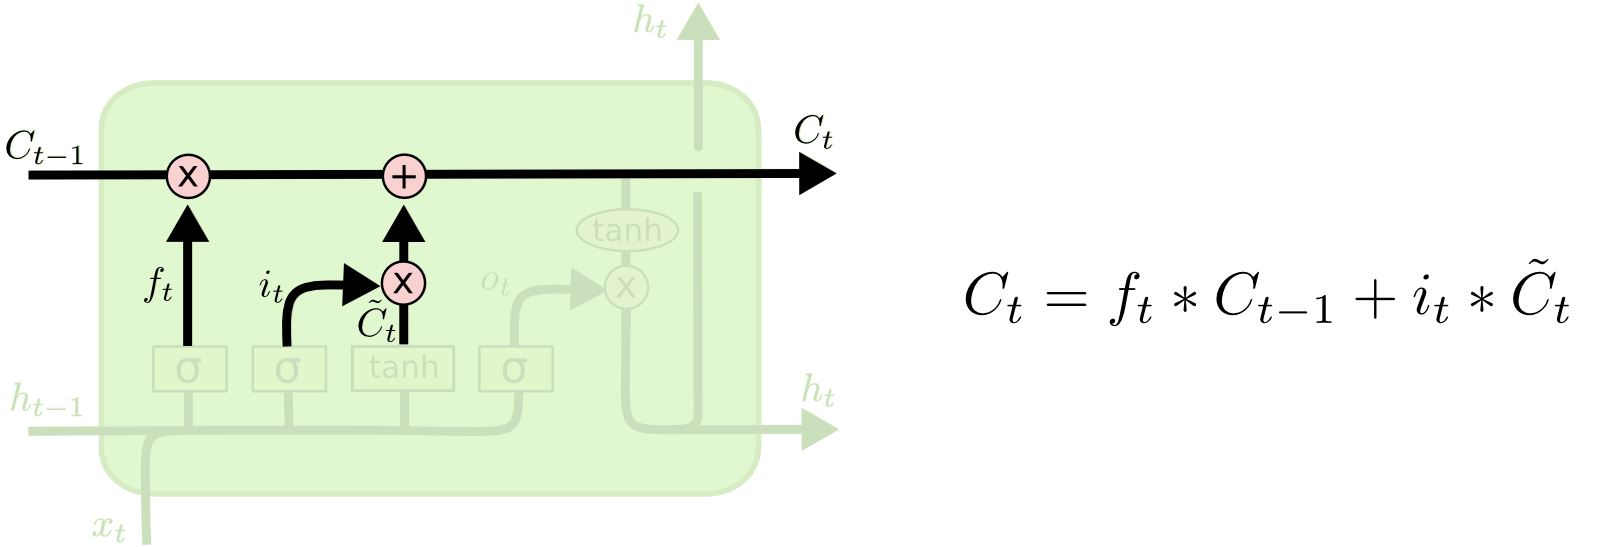 셀 상태 업데이트 단계
앞서 ‘망각 게이트(forget gate)‘와 ‘입력 게이트(input gate)‘를 통해 준비를 마쳤다면, 이제 실제로 컨베이어 벨트(Cell State)에 정보(기억)을 갱신해야 한다.
이 단계는 ”과거의 기억 중 남길 것”과 ”새로운 기억 중 더할 것”을 합치는 과정이다.
- 업데이트 공식: 과거와 현재의 결합
- 살아남은 과거 ($f_t \times C_{t-1}$)
- 이전 시점의 기억($C_{t-1}$)에 망각 게이트 값($f_t$, 0~1)을 곱해서 불필요한 기억을 지운 상태
→ Forget Gate의 최종 반영값
- 이전 시점의 기억($C_{t-1}$)에 망각 게이트 값($f_t$, 0~1)을 곱해서 불필요한 기억을 지운 상태
- 반영된 현재($i_t \times \tilde{C}_t$)
-
Tanh가 제안한 새로운 정보 후보군($\tilde{C_t}$, -1~1)에 입력 게이트의 승인 비율($i_t$, 0~1)을 곱해서, 중요하다고 선택된 정보만 남긴 상태
→ Input Gate의 최종 반영값- $i_t$ = Input Gate의 Sigmoid Layer의 출력값 (0 ~ 1)
- $\tilde{C}_t$ = Input Gate의 Tanh Layer의 출력값, candidate (-1 ~ 1)
-
- 최종 결과 ($C_t$)
- 이 두 값을 더하기(+) 하여 다음 시점으로 넘겨줄 최종 셀 상태(장기 기억)를 완성한다.
💡 곱셈이 아닌 덧셈을 하는 이유?
1. 기울기 소실 (Vanishing Gradient) 방지
- 일반 RNN은 곱셈을 하면서 상태를 업데이트한다. 1보다 작은 수를 계속 곱하면 값은 결국 0으로 수렴해서 사라진다. (오래된 기억이 사라지는 이유)
- 반면, LSTM은 더하기 연산을 사용한다. 미분(역전파)할 때, 더하기 연산은 기울기를 그대로 뒤로 전달해주는 역할을 하므로 정보가 멀리까지 살아남을 수 있다.
2. 정보의 누적 (ResNet과 유사)
- 컴퓨터 비전의 ResNet(Residual Network)이 층을 깊게 쌓아도 학습이 잘 되는 이유는 입력을 출력에 더해주기 `SkipConnection`을 통해 입력을 출력에 더해주기 때문이다.
- LSTM의 Cell State도 이와 유사하게 기존 기억을 덮어쓰는(overwrite)게 아니라 기존 기억 위에 정보를 얹는(add) 방식으로 작동하기 때문에 장기 기억 보존에 탁월하다.💡 왜 $Tanh$(-1 ~ 1)을 사용할까?
LSTM 내부에는 두 종류의 활성화 함수가 있다
- Sigmoid (0 ~ 1): 문을 여닫는 '게이트(비율)' 역할
- Tanh (-1 ~ 1): 실제 데이터인 '정보(information)' 역할
후보군 $\tilde{C}_t$을 만들 때 $Tanh$을 쓰는 이유는 정보의 방향성 때문이다.
- 양수 (+): 정보를 강화 (e.g. 주가 상승, 긍정 감정)
- 음수 (-): 정보를 감쇄하거나 반전 (e.g. 주가 하락, 부정 감정)
- 0: 중립
→ 이 단계에서 만들어진 정보는 아직 확정된 게 아니기 때문에 후보군이라고 부른다.
만약 0-1 사이의 값(Sigmoid)만 사용해서 계속 더한다면, 숫자가 줄어들지않고 무조건 커지기만 해서, 나중에는 값이 무한대로 발산할 가능성이 있다. 따라서 Tanh은 음수값을 통해 이것들을 제한한다. - 예시, 영화 리뷰 분석 시뮬레이션
- LSTM이 ‘이 영화는 지루한(boring) 영화다문장을 읽었다고 가정해보자.
- 내부적으로 3가지 속성(Index)을 추적 중이다.
Index 0: 재미 (Positive=1, Negative=-1)Index 1: 장르-액션 (High=1, Low=0)Index 2: 시제 (Future=1, Past=-1)
Step 1) Tanh (후보군 생성) 단계
-
‘지루한($x_t$)’이라는 단어를 보고 Tanh Layer가 의견(후보 벡터 $\tilde{C}_t$)을 낸다
- Candidate Vector:
[-0.9, -0.1, 0.0]Index 0 (재미): -0.9 (아주 재미없음! 점수 깎기)Index 1 (액션): -0.1 (액션이랑은 관계없지만, 약간 정적인 느낌?)Index 2 (시제): 0.0 (시제랑은 상관없음)
- Candidate Vector:
Step 2) Input Gate (입력 게이트) 단계
-
동시에 Sigmoid 층이 문맥을 보고 중요도($i_t$)를 판단한다. (목표: 영화 평점 매기기)
-
Input Gate Vector:
[1.0, 0.1, 0.0]Index 0 (재미): 1.0 (평점에 핵심적인 정보야. 무조건 반영!)Index 1 (액션): 0.1 (액션 여부는 평점에 별로 중요하지 않음)Index 2 (시제): 0.0 (시제도 평점이랑 관련 없음)
Step 3) Update (곱하기 & 더하기) 단계
-
이제 후보군과 게이트를 곱해서 기존 기억($C_{t-1}$)에 더한다
속성 Tanh (의견) Input Gate (필터) 최종 반영값 ($\tilde{C}_t \times i_t$) 결과 재미 -0.9 1.0 -0.9 기존 재미 점수에서 0.9만큼 대폭 깎음 액션 -0.1 0.1 -0.01 거의 반영 안 됨 시제 0.0 0.0 0.0 전혀 반영 안 됨
결과적으로 LSTM은 “지루하다”는 단어를 통해 영화의 재미 점수만 골라서 낮추는(update) 정교한 작업을 수행하게 된다.
3 . 출력 게이트 (Output Gate): 최종 결과를 내보내는 단계
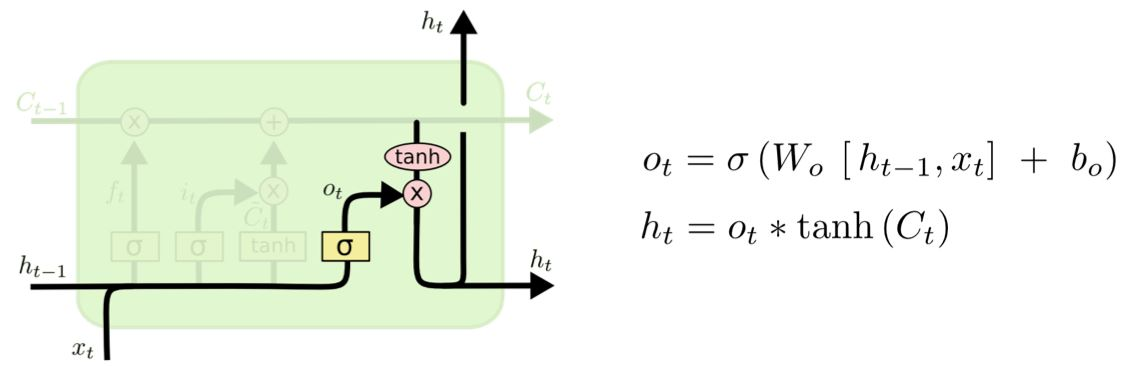 입력 게이트 단계
- 현재 가진 정보(장기 기억)를 바탕으로 최종 결과(단기 기억 및 출력)를 내보내는 단계이다.
- e.g. 주어가 사람(단수/복수, 성별, etc.)이라는 것을 파악했으므로, 뒤에 올 동사도 그에 맞는 형태를 내보내도록 결정하는 역할
- 출력 게이트는 혼자서 Output을 결정하지 않고, 방금 만든 업데이트를 마친 Cell State($C_t$)을 가져와서 사용한다.
[출력 게이트 과정 정리]
- Output Gate($o_t$): 지금 가진 정보 중 몇 %나 밖으로 보낼까? (sigmoid로 결정, 0~1)
- Cell State 변환: 방금 갱신된 장기 기억($C_t$)을 가져와서 Tanh 함수를 씌운다. (값이 너무 커지지 않도록 -1 ~ 1로 정규화 및 포장)
- 최종 출력 ($h_t$) 계산
$h_t = o_t \times \tanh(C_t)$
출력 단계는 방금 갱신된 장기 기억($C_t$)을 Tanh으로 정규화한 뒤, 출력 게이트($o_t$)가 허락한 비율만큼만 필터링하여 Hidden State($h_t$)로 내보내는 과정이다.
이렇게 만들어진 $h_t$는 다음 시점(t+1)의 LSTM 셀로 넘어가고, 동시에 다음 층(Dense Layer)으로도 전달되어 우리가 원하는 최종 예측값이 된다.
전체 데이터 흐름 정리
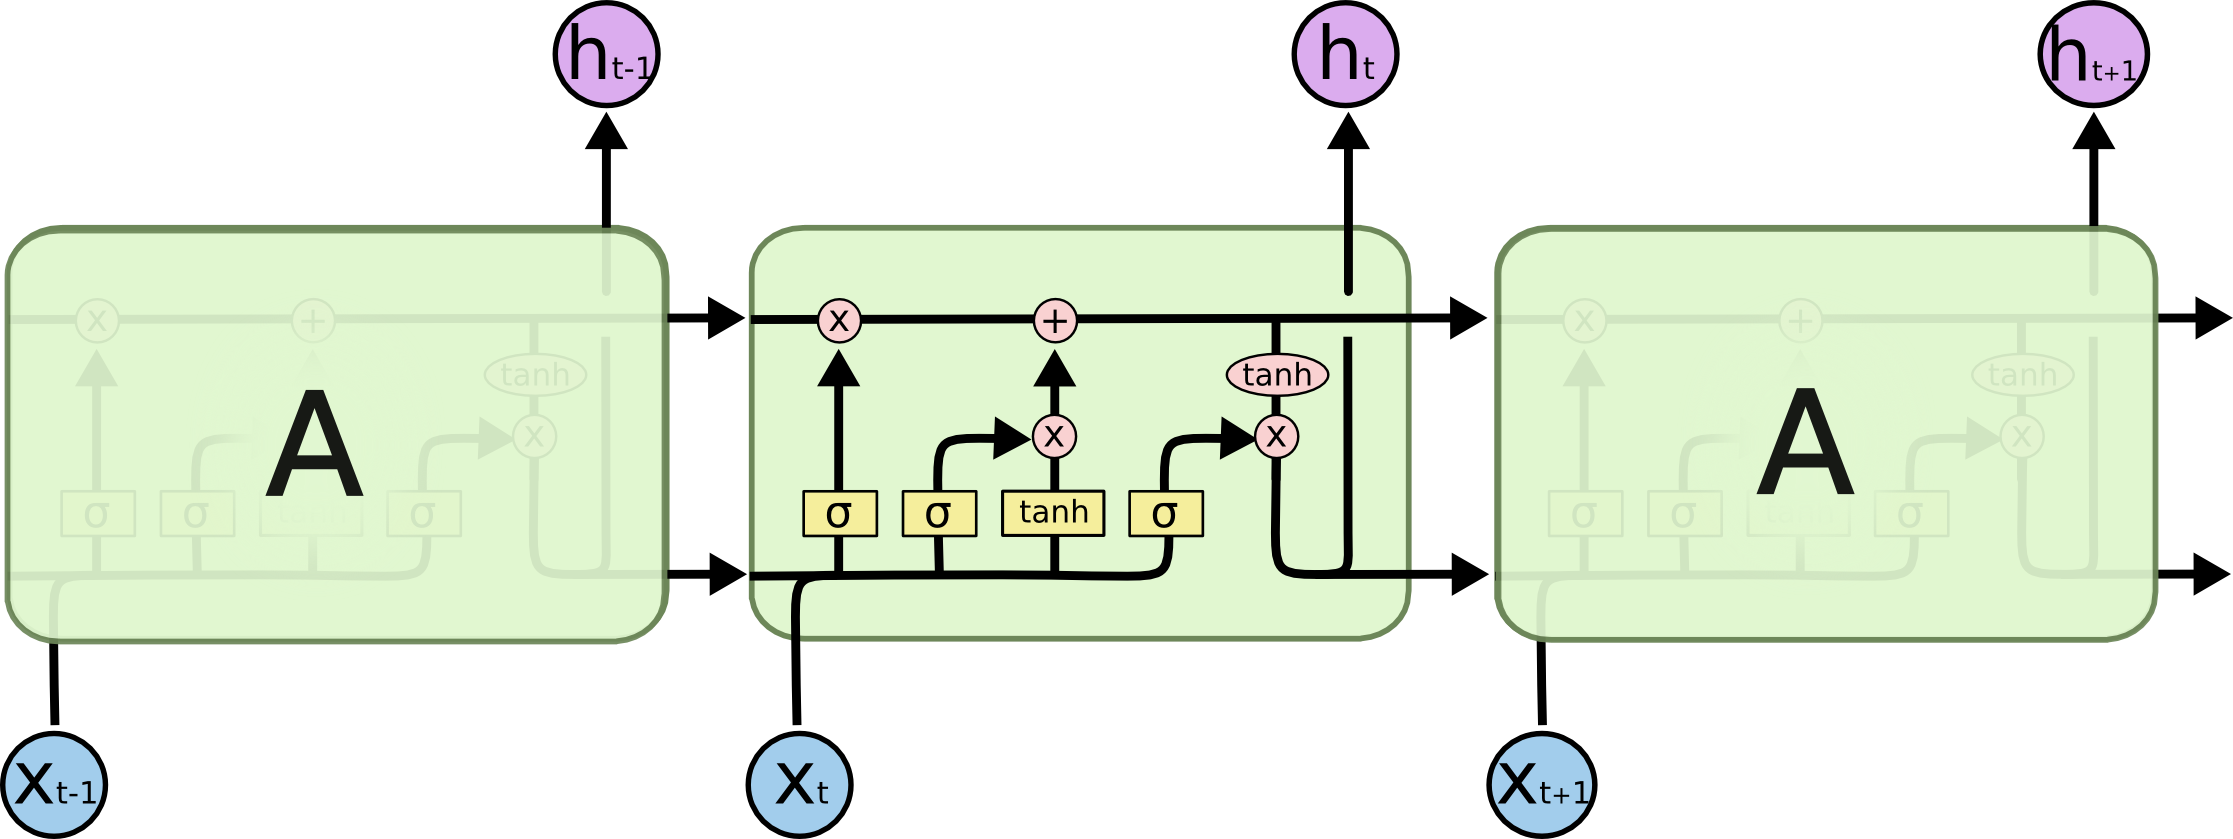 LSTM 전체 데이터 흐름
- 이전 시점의 기억 도착
- 이전 블록에서 넘어온 단기 기억($h_{t-1}$) 과 장기 기억($C_{t-1}$)이 셀에 도착한다.
- 망각 결정 (Forget Gate)
- 현재 데이터($x_t$)와 단기 기억($h_{t-1}$)을 보고, 과거 기억 중 ‘얼마나 잊을지’ 가중치($f_t$)를 정한다.
- 과거 필터링
- 가져온 과거 기억($C_{t-1}$)에 망각 가중치($f_t$)를 곱해서 ‘살아남은 과거’를 만든다. (이 과정에서 기존의 원본 $C_{t-1}$은 덮어씌워진다.)
- 새로운 정보 승인 (Input Gate)
- 다시 $x_t$와 $h_{t-1}$을 보고 “얼마나 저장할지” 승인 비율($i_t$)을 정하고, Tanh로 새로운 후보군($\tilde{C}_t$)을 만든 뒤 둘을 곱해 ‘반영된 현재’를 만든다.
- 기억 업데이트 (Cell State Update)
- ‘살아남은 과거’와 ‘반영된 현재’를 더해 이번 시점의 최종 장기 기억 ($C_t)$을 완성한다.
- 최종 출력 (Output Gate)
- 완성된 $C_t$는 다음 LSTM 블록으로 전달되고, 동시에 C_t$C_t$($o_t$)을 곱해 현재 시점의 최종 단기 기억이나 출력값 ($h_t$)을 만들어 내보낸다.
| 구분 | 명칭 | 역할 | 활성화 함수 | 비유 |
|---|---|---|---|---|
| 1. Gate | Forget Gate | 과거를 얼마나 잊을지 결정 | Sigmoid (0 ~ 1) | 삭제 담당 게이트 |
| 2. Gate | Input Gate | 입력을 얼마나 받을지 결정 | Sigmoid (0 ~ 1) | 입력 담당 게이트 |
| 3. Info | Cell Candidate | 새로 기억할 실제 내용 후보 | Tanh (-1 ~ 1) | 새로운 정보 덩어리 |
| 4. Gate | Output Gate | 결과를 얼마나 내보낼지 결정 | Sigmoid (0 ~ 1) | 출력 담당 게이트 |