[LSTM] LSTM의 동작 원리 1편
기존 RNN(순환신경망)의 문제점
-
단기 기억은 우수함
RNN은 바로 직전의 데이터(Short-term)를 현재의 결과에 반영하는 데에는 강점이 있다.
-
장기 기억의 부재 (Long-Term Dependency; 장기 의존 문제)
하지만 데이터의 길이가 길어지면, 앞쪽의 중요한 정보가 뒤쪽까지 전달되지 못하고 희미해지는 문제가 발생한다.
-
e.g. “나는 프랑스에서 자랐어… (중략) … 그래서 나는 프랑스어를 유창하게 해” (I grew up in France … so I’m fluent in French)
-
이 문장의 마지막 단어인 ‘프랑스어’를 예측하려면 문장 앞부분의 ‘프랑스’라는 맥락을 기억해야 한다.
-
하지만 문장이 길어질수록(거리가 멀어질수록) 역전파 과정에서 기울기 소실 (Vanishing Gradient)이 발생하여, RNN은 앞 부분의 정보를 잊어버리게 된다.
-
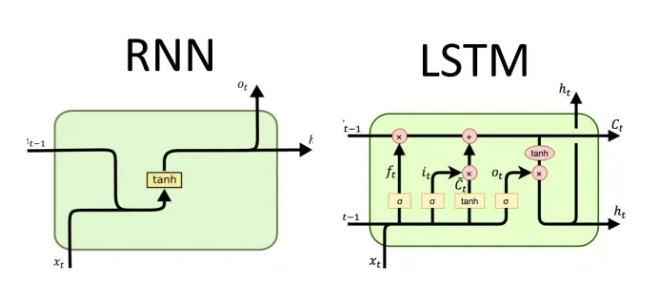 Vanilla RNN과 LSTM
LSTM 모델의 전체 흐름: 데이터는 어떻게 흐르는가?
모델을 처음 공부할 때 데이터가 어떻게 흘러가는지 전체적인 흐름을 파악해야 이해가 되어서 LSTM 층의 내부 구조를 공부하기 전에 LSTM 모델 자체의 전체적인 흐름을 먼저 알아보고자 한다.
앞서 말한 RNN의 문제를 해결하기 위해, LSTM은 중요한 정보를 오랫동안 간직할 수 있는 특별한 구조를 가진다.
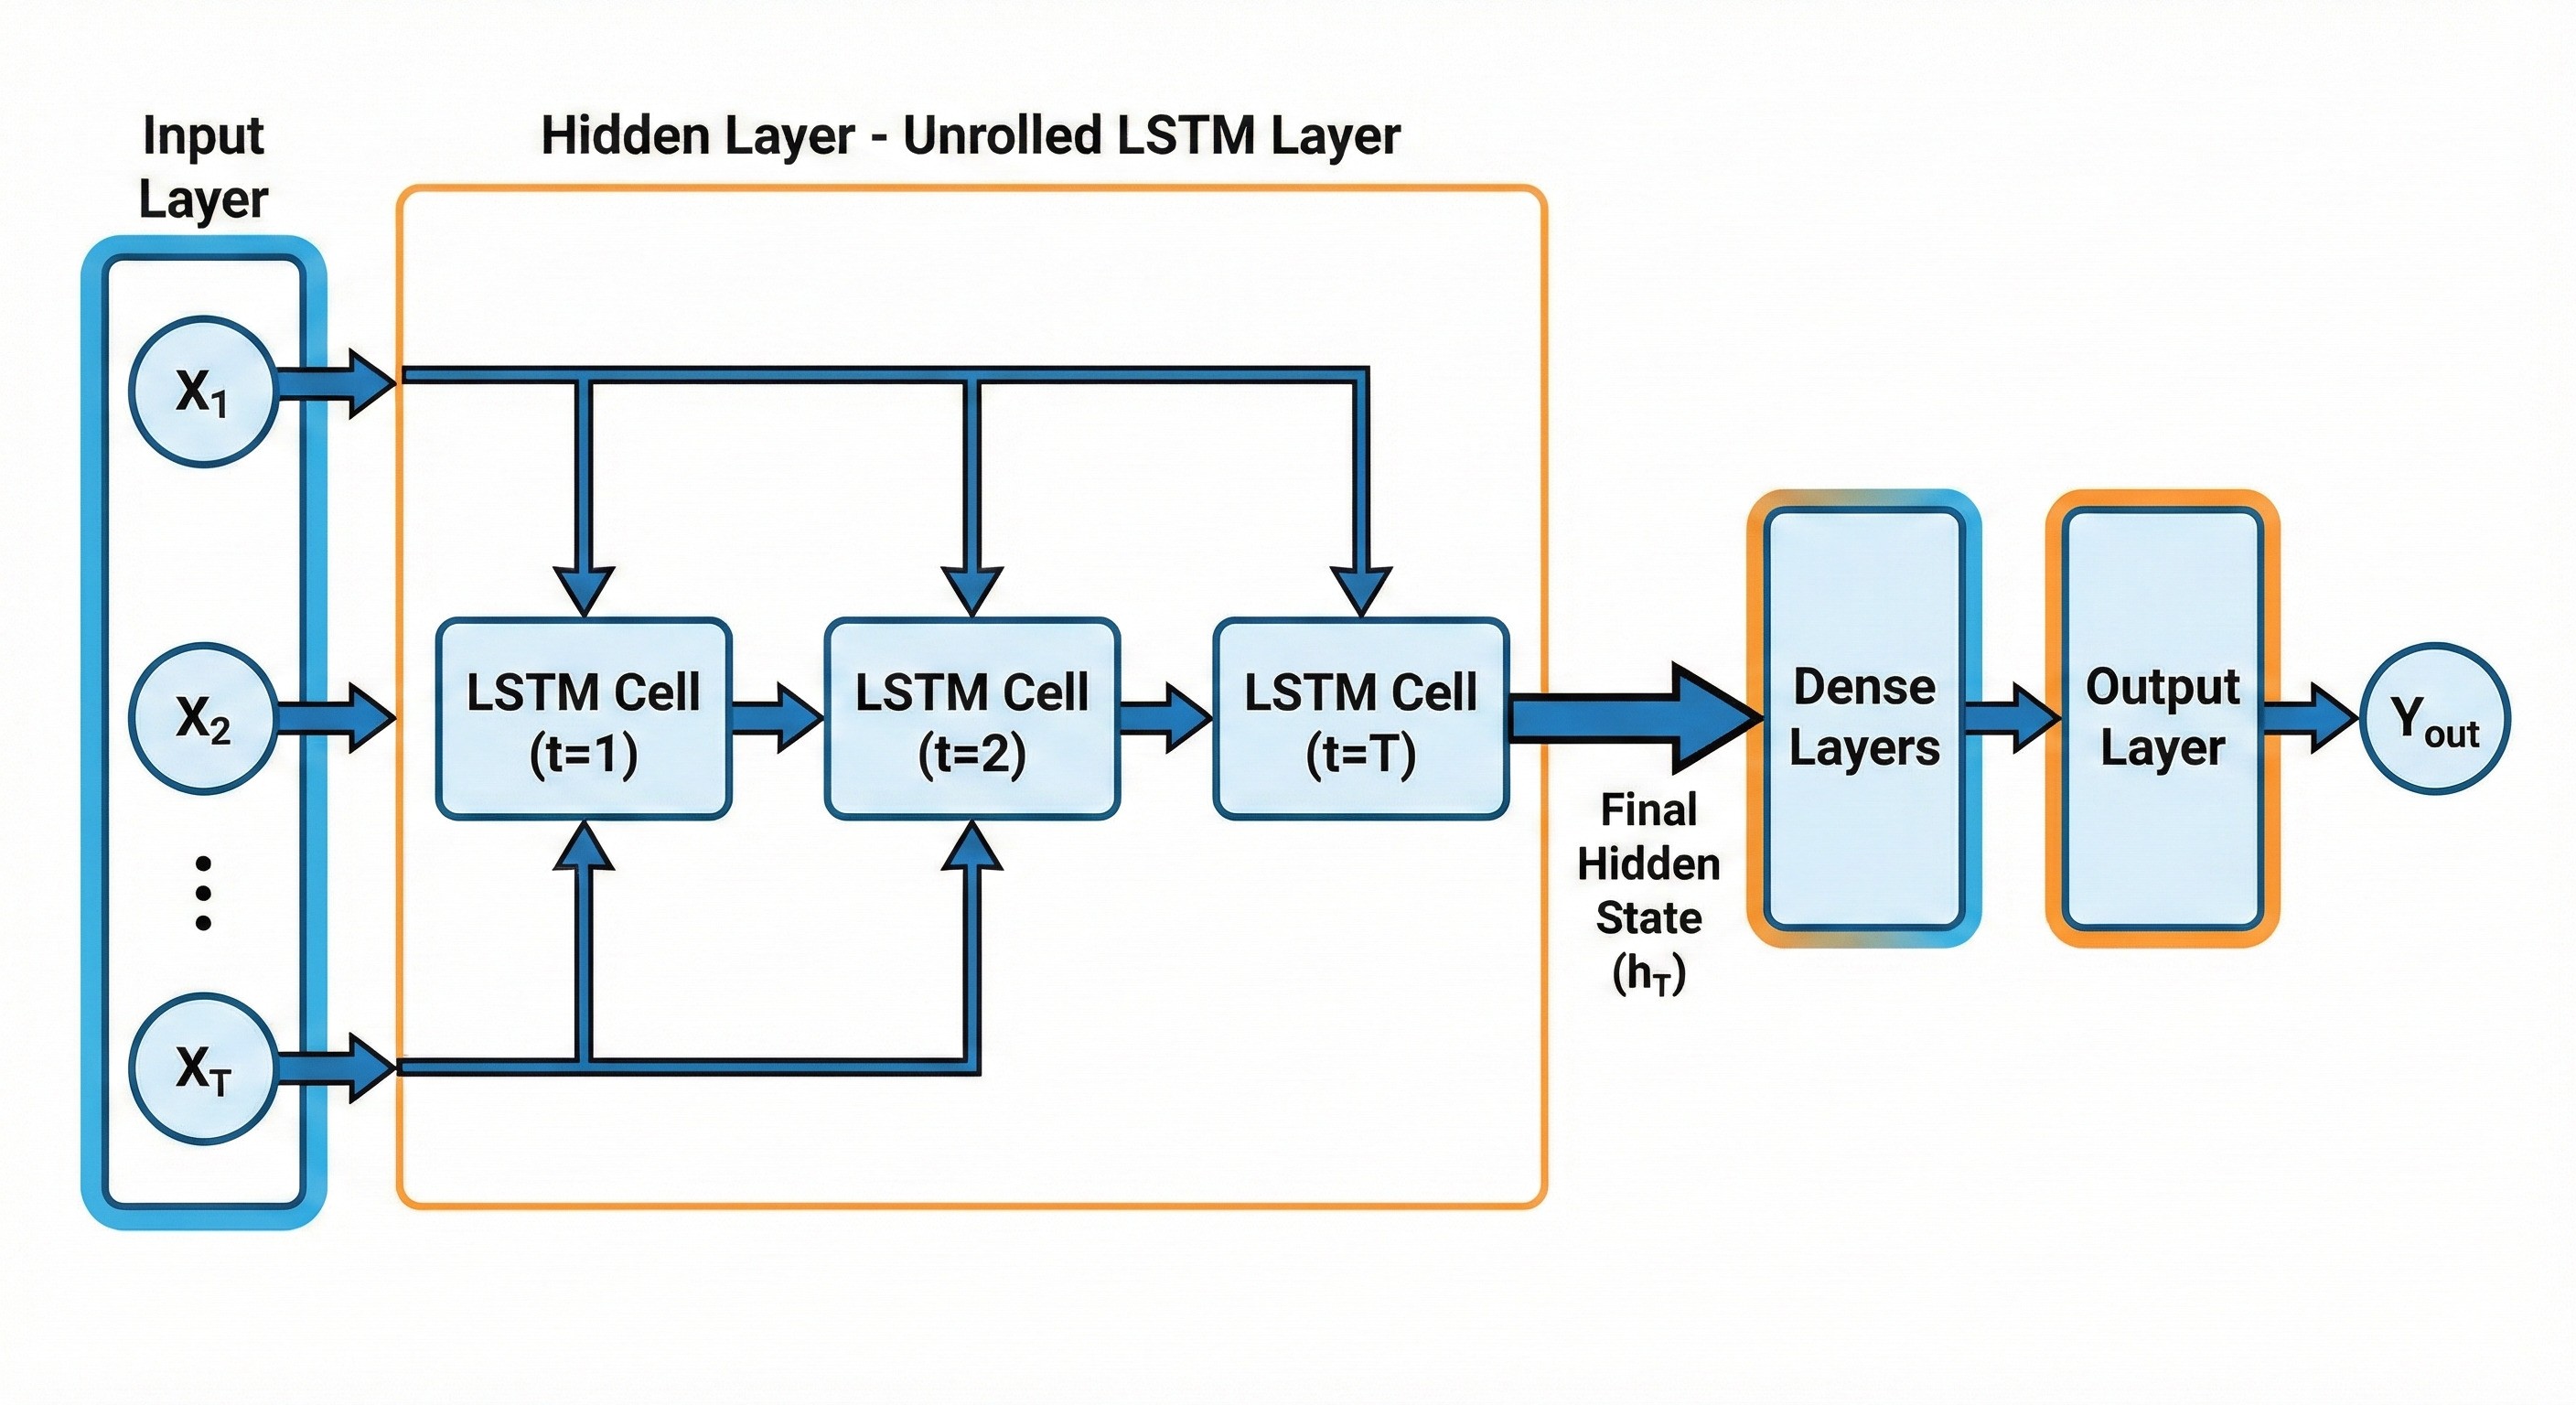
전체적인 LSTM 신경망 구조는 다음과 같다:
 gemini 생성 이미지
- Input Layer (입력층)
-
데이터가 모델로 들어오는 입구이다.
-
시계열 데이터(순서가 있는 데이터)는 (Time steps, Features)의 형태를 가진다.
- e.g. 시계열 예측: “3일치 데이터로 주가 예측” → (3일치 데이터, [시가, 종가, 거래량]) → Time Step은 3가 된다.
- e.g. 문장 감성 분석: “영화가 너무 재밌어요” → (3개의 단어, [각 단어의 백터 표현]) → Time Step은 3이 된다.
- 즉,
Day1→Day2→Day3의 순서, 또는영화가(t1)→너무(t2)→재밌어요(t3)순서로 데이터가 차례대로 들어갈 준비를 한다는 것.
-
- Hidden Layer (LSTM Layer)
-
이곳이 모델의 핵심인 LSTM 구간이다.
-
코드 상으로는 하나의 층(Layer)처럼 보이지만, 실제 작동할 때에는 아래의 그림처럼 시간 순서대로 펼쳐진(unrolled) 구조로 데이터를 처리한다.
-
작동 원리 (여기선 간단하게)
-
Day1(t1) 데이터를 받아 처리하고, 그 기억(Hidden State)을 Day2(t2)로 넘긴다.
-
Day2(t2)는 Day1의 기억과 현재 들어온 정보(t2)를 합쳐서 Day3(t3)로 넘긴다.
-
이 과정에서 중요한 정보(장기 정보)는 Cell State($C_t$)라는 고속도로에 태워 정보의 손실 없이 마지막 시점(t3)까지 운반한다.
-
모든 시점(t3)의 처리가 끝나면, 과거의 문맥 정보를 압축한 최종 요약본(Hidden State, $h_t$)을 다음 층인 Dense Layer으로 전달하여 최종 결과를 예측한다.
-
-
- Dense Layers & Output Layer (출력층)
-
LSTM이 넘겨준 요약본($h_t$)을 받아, 우리가 원하는 최종 정답으로 변환하는 단계이다.
-
보통 Dense Layer (Fully Connected Layer)가 이 역할을 수행한다.
-
Dense Layer는 LSTM 층과 최종 출력 사이에 더 복잡한 계산을 위해 여러 개의 Dense Layer(중간층)가 올 수 있다.
-
하지만 가장 마지막에 위치한 Dense Layer가 최종 결과물을 내놓기 때문에 이 마지막 층을 Output Layer(출력층)이라고 부른다.
-
역할
- LSTM의 출력($h_t$): 기계가 이해하는 복잡한 숫자들의 집합 (Vector)
- Output Layer의 역할: 우리가 원하는 형태의 정답으로 계산해준다.
- e.g. 긍정일 확률 95% (0.95라는 숫자 1개로 출력)
- e.g. 내일의 주가 (1개의 숫자 출력)
-
LSTM의 내부 구조: 큰 그림 그리기
LSTM의 내부 구조를 알아보기 전에,
LSTM 셀 하나가 어떤 부품들을 가지고 있고, 데이터가 어떻게 지나가는지 먼저 확인해보겠다.
[일단 결론부터]
3개의 게이트 + 1개의 데이터 생성기
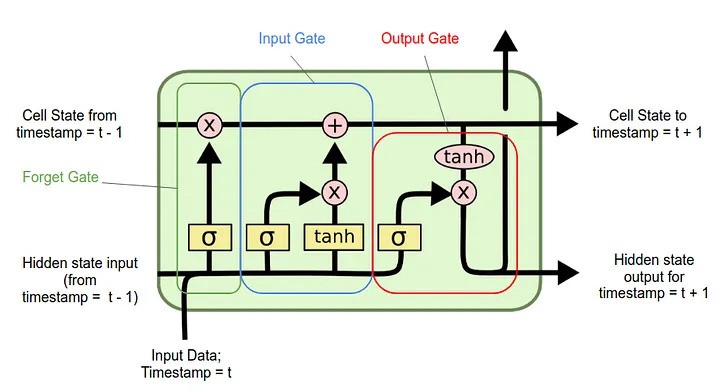 출처: https://medium.com/analytics-vidhya/lstms-explained-a-complete-technically-accurate-conceptual-guide-with-keras-2a650327e8f2
LSTM 셀 내부에는 정보를 조절하는 4가지 핵심 부품이 있다. 그림에서 세 개의 $\sigma$(시그마)와 $\tanh$(탄젠트)를 찾아보면 된다!
- 3개의 게이트 (Sigmoid 함수, $\sigma$)
-
정보의 문을 열고 닫는다.
-
0-1 사이의 값을 출력하여 정보를 아예 차단(0)하거나 전부 통과(1) 시켜 정보 통과량을 조절한다.
-
역할별로 Forget Gate, Input Gate, Output Gate가 있다.
-
- 1개의 데이터 생성기 (Tanh 함수, $\tanh$)
-
Input Gate의 짝으로, 기억할 만한 새로운 후보 데이터를 만들어내는 역할이다.
-
$-1$ ~ $1$ 사이의 값을 가진다 (강한 부정 ~ 강한 긍정)
-
LSTM 셀(Cell) 하나의 입출력 구조: 두 개의 길
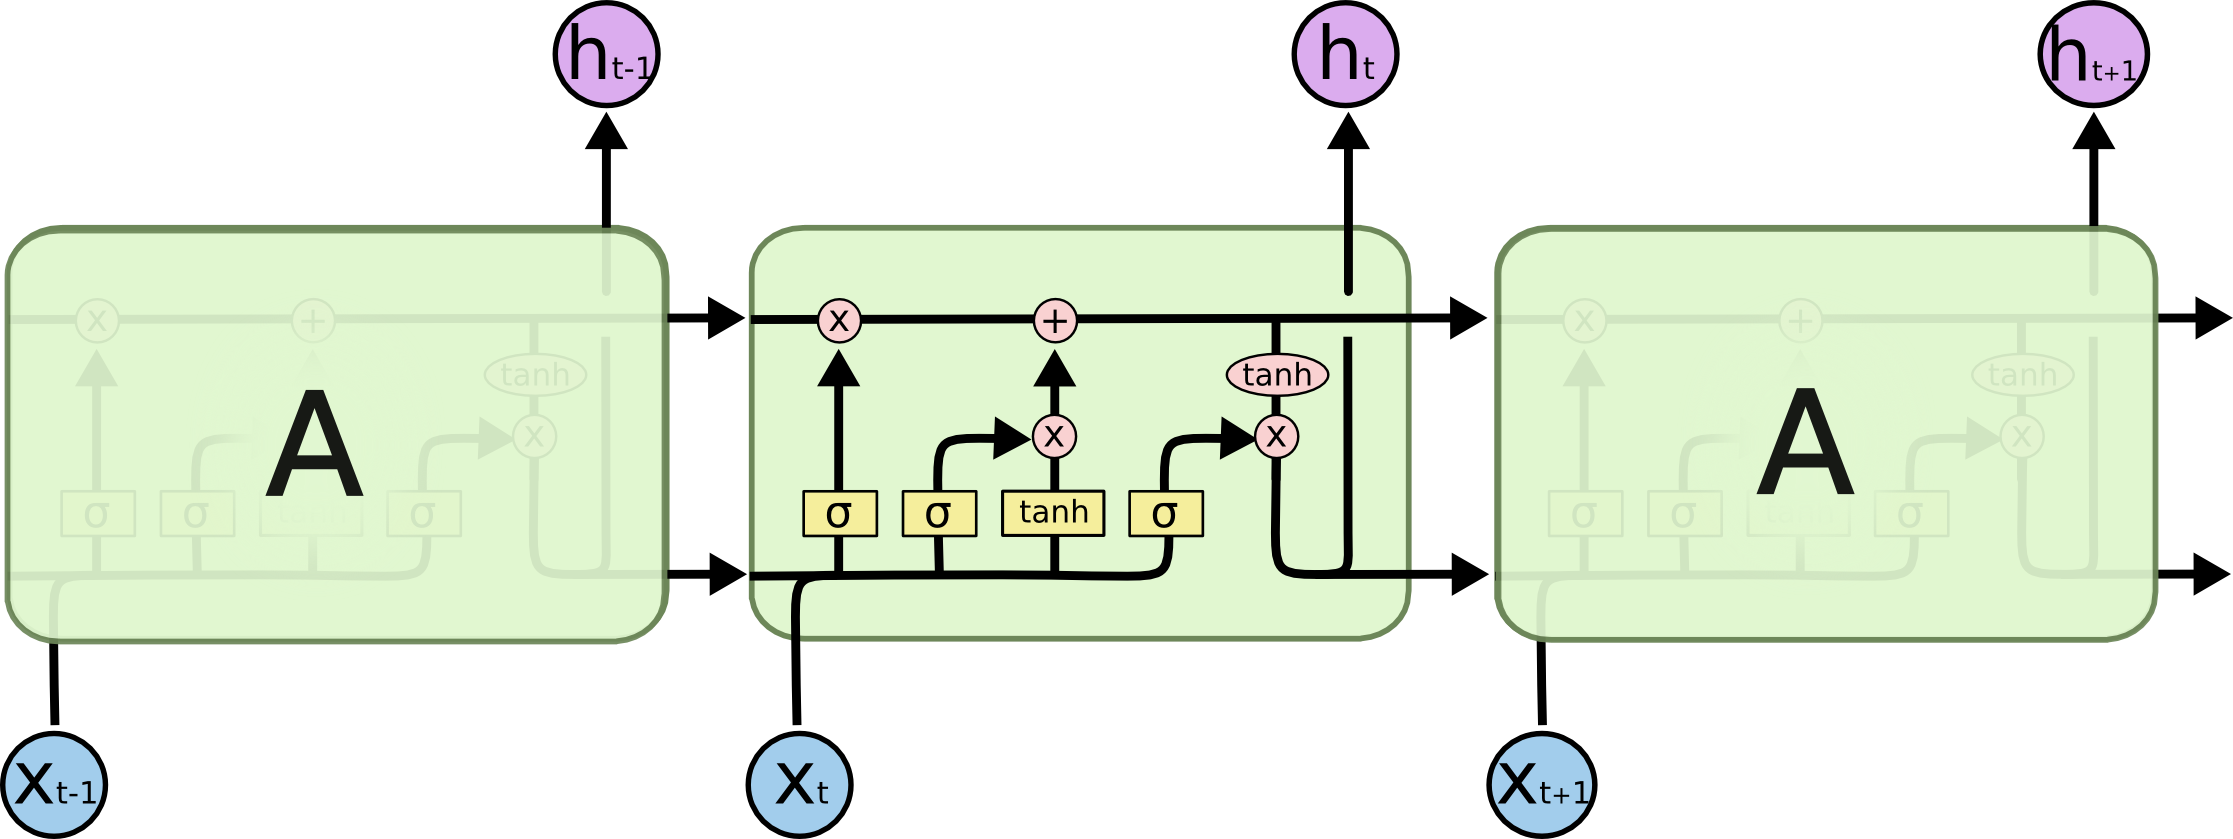
LSTM 블록을 보면, 이전 시점에서 넘어와서 다음 시점으로 넘어가는 화살표가 두 개라는 점이 가장 중요하다.
 출처: https://colah.github.io/posts/2015-08-Understanding-LSTMs/
- 윗길: Cell State ($C_t$, 장기 기억)
-
컨베이어 벨트: 위에서 고속도로라고 표현한 길이다. 외부(다음 층인 Dense Layer)로는 직접 나가지 않고, 오직 LSTM 셀들끼리만 공유하는 순수한 기억의 전용 도로라고 할 수 있다.
-
정보 손실 최소화: 이 길은 복잡한 활성화 함수(Sigmoid, Tanh, etc.)를 거치지 않는다.
-
필요한 정보를 더하거나(add), 불필요한 정보를 곱해서 잊어버리는(multiply) 선형적인 연산만 수행한다.
-
따라서 먼 과거의 정보도 기울기 소실 없이 비교적 온전하게 끝까지 흘러갈 수 있다.
-
-
나중 단계에서 LSTM의 출력으로 내보낼 ‘살아남은 과거’의 재료가 된다.
-
- 아랫길: Hidden State ($h_t$, 단기 기억/출력)
-
현재 시점의 최종 출력값: 이 값은 만들어지자마자 두 군데로 갈라져서 나간다.
-
다음 시점($t+1$)의 LSTM 셀로 전달된다. (단기 기억 전달; 다음 단계의 판단 근거)
-
다음 층(Dense Layer)로 전달되어 최종 예측의 재료로 쓰인다. (참고: Many-to-One 방식에서는 중간 단계의 $h_t$는 무시하고, 마지막 시점의 $h_t$만 사용한다)
-
-
생성 과정: 윗길의 장기 기억(Cell State)을 가져와서 Tanh로 가공한 뒤, 출력 게이트(Output Gate, $o_t$)를 통해 “지금 당장 필요한 정보”만 필터링해서 만든다.
즉, 전체 기억 중 현재 문맥에서 가장 중요한 판단 근거가 되는 값이다.
-
[참고] 입력값 $x_t$의 정체: 스칼라가 아닌 벡터!
LSTM 셀에 들어오는 입력 $x_t$는 숫자 하나(스칼라)가 아니라, 숫자들의 묶음(벡터)다.
- NLP (자연어 처리)의 경우:
- ‘사과’라는 단어 하나가 들어오면, 임베딩 과정을 거쳐
[0.1, -0.5, 0.9 ...]와 같은 밀집 벡터 (Dense Vector)로 변환되어 $x_t$로 들어온다. 각 숫자는 모델이 알아서 학습한 단어의 추상적인 속성을 의미한다.
- ‘사과’라는 단어 하나가 들어오면, 임베딩 과정을 거쳐
- 회귀 분석의 경우:
-
(주가 예측 예시) 하루 동안의 데이터로
[시가, 고가, 거래량]3가지 정보가 있다면, 길이 3짜리 벡터[1000, 1200, 50000]이 그대로 $x_t$가 된다. -
이 벡터는 나중에 LSTM 내부에서 가중치 행렬($W$)과 곱해지면서 더 많은 개수의 추상적인 특징(Hidden Units)로 변환되어 처리된다. (Feature Extraction)
-